Najpierw porządek w danych. Potem AI.
Wotomio buduje procesy ETL, hurtownie i bazy danych — a na nich automatyzacje AI, które naprawdę wykonują pracę. Szybko uruchamiamy i zostajemy, żeby pilnować instalacji.
- Surowe dane
- Dane zweryfikowane
- Dane w hurtowni
- Sygnał AI i monitoringu
Rysunek
Instalacja danych
Nr
WTM-PID-001
Rew.
A
Fundament przed AI
AI jest tak dobre, jak dane pod nim. Dlatego budujemy całą instalację od dołu — a każdą warstwę da się odczytać na dwa sposoby: co daje biznesowi i co oznacza dla Twojego zespołu IT.
Dla biznesu
Przekrój A–A
Dla zespołu IT
Rutyna znika: dokumenty same się klasyfikują, pytania dostają odpowiedzi, prognozy przychodzą same.
AIC-500
AI i automatyzacje
Modele LLM i ML, agenci, wyszukiwanie na danych z hurtowni, wyzwalacze procesów.
Zarząd widzi te same liczby w każdym raporcie — bez sporów, czyj Excel ma rację.
X-700
Raporty i model semantyczny
Warstwa semantyczna, definicje miar, dashboardy BI, uprawnienia.
Jedno miejsce z pełną historią firmy, gotowe na każde pytanie.
TK-300
Hurtownia i bazy danych
Model wymiarowy, staging/core/mart, projektowanie, strojenie i migracje baz danych.
Dane przychodzą same, na czas i sprawdzone. Koniec z kopiowaniem między systemami.
P-200 · F-210 · R-220
ETL/ELT i jakość danych
Orkiestrowane pipeline’y, ładowania przyrostowe, testy jakości, alerty.
ERP, CRM, sklep i arkusze zostają tam, gdzie są — my się do nich podłączamy.
V-100
Systemy źródłowe
Konektory, API, repliki baz, import plików, integracje.
Od audytu do rozruchu w kilka tygodni
Instalację danych uruchamiamy tak, jak inżynierowie uruchamiają zakład: stacja po stacji, każda sprawdzona, zanim otworzy się kolejny zawór.
-
01
Audyt danych
Mapujemy źródła, przepływy i miejsca, w których dane giną albo są przepisywane ręcznie. Dostajesz listę priorytetów.
-
02
Projekt instalacji
Architektura, model danych i pierwsza automatyzacja, która ma sens — dopasowane do budżetu, nie do katalogu.
-
03
Budowa i testy
Przepływy, hurtownię i AI budujemy w krótkich iteracjach. Każda kończy się czymś, co możesz sprawdzić.
-
04
Rozruch
Pierwszy działający przepływ danych rusza po tygodniach, nie miesiącach. Twój zespół uczy się na prawdziwych danych.
-
05
Eksploatacja i opieka
Monitorujemy przebiegi i jakość danych, naprawiamy usterki i dokładamy kolejne automatyzacje.
Zacznij od audytu danych
Zanim cokolwiek zbudujemy, sprawdzamy to, co już masz. Audyt pokaże, gdzie wyciekają dane, co warto zautomatyzować i od czego zacząć — niezależnie od tego, czy dalej pracujesz z nami.
Protokół przeglądu
AUD-001
Co otrzymujesz
- Mapa systemów źródłowych i przepływów danych, także tych ręcznych.
- Ocena jakości danych: gdzie rekordy giną, dublują się lub sobie przeczą.
- Procesy warte automatyzacji AI, uszeregowane według nakładu i zysku.
- Plan pierwszej instalacji: zakres, architektura, kolejne kroki.
Wynik: raport na piśmie i warsztat roboczy z Twoim zespołem.
Instalacje, które zbudowaliśmy
-
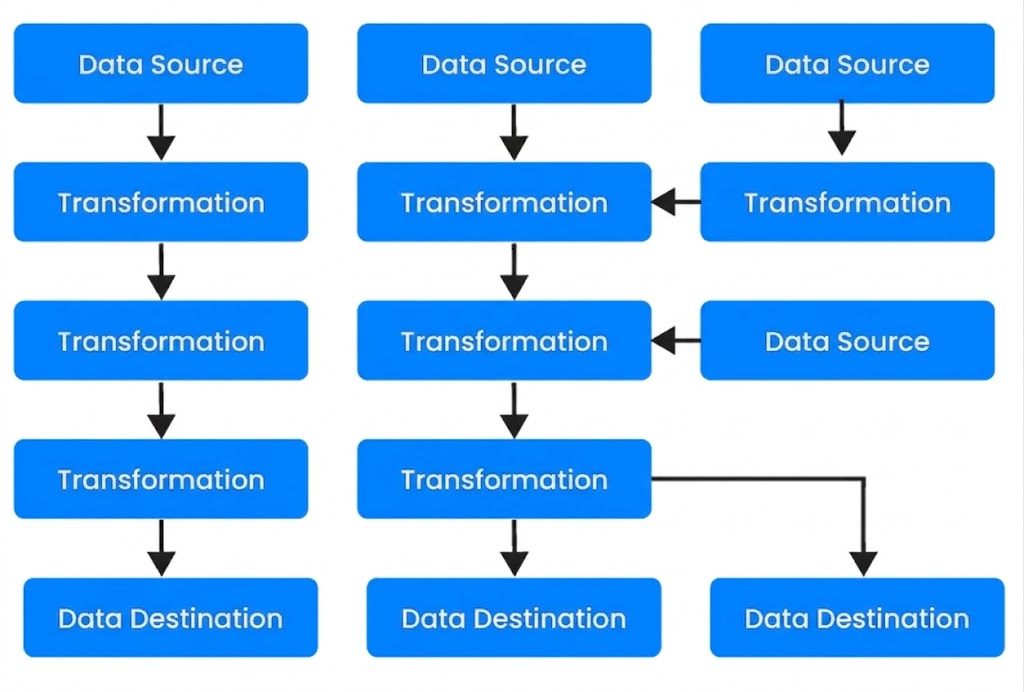
Stworzenie bazy przepływów bankowych
Stworzenie bazy danych sprawozdawczych bankowych ładowanych z plików w SQL Server i aktualizowanych raz dziennie wraz ze szkieletem pod raportowanie oraz możliwością tworzenia samodzielnych raportów w PowerBI przez…
Branża
Zakres
Bazy danych
-
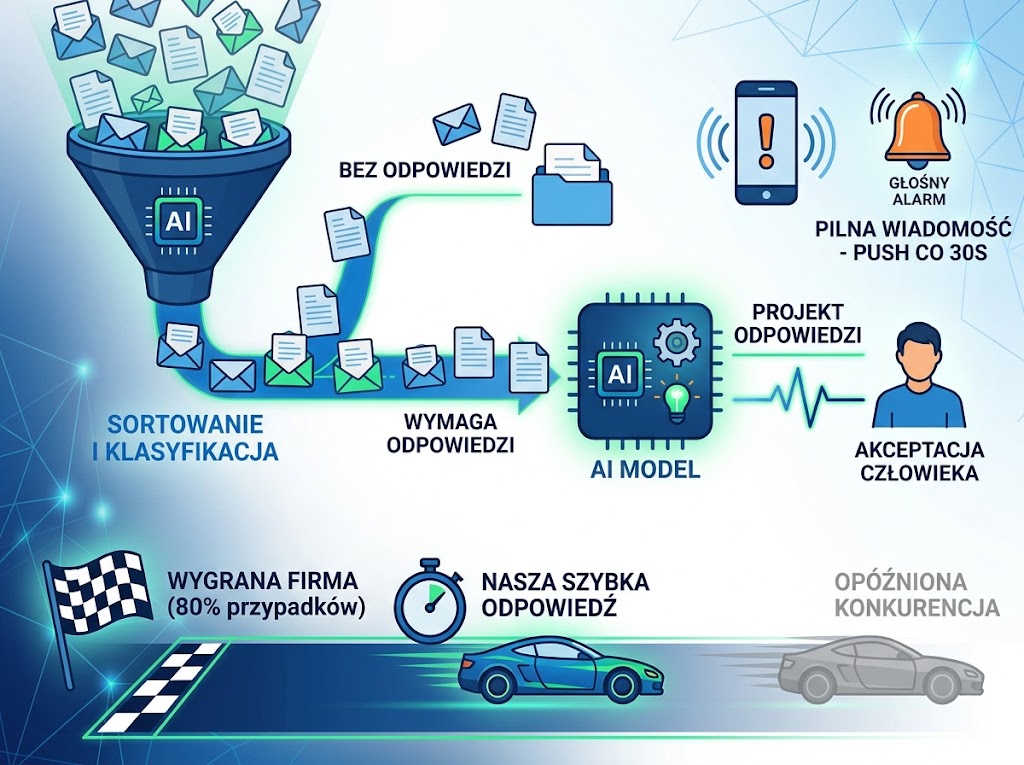
Automatyczna klasyfikacja dokumentów i maili
System analizuje treść przychodzących dokumentów oraz wiadomości e-mail, klasyfikując je i kierując do odpowiednich procesów.
Branża
Zakres
AI + integracje
-
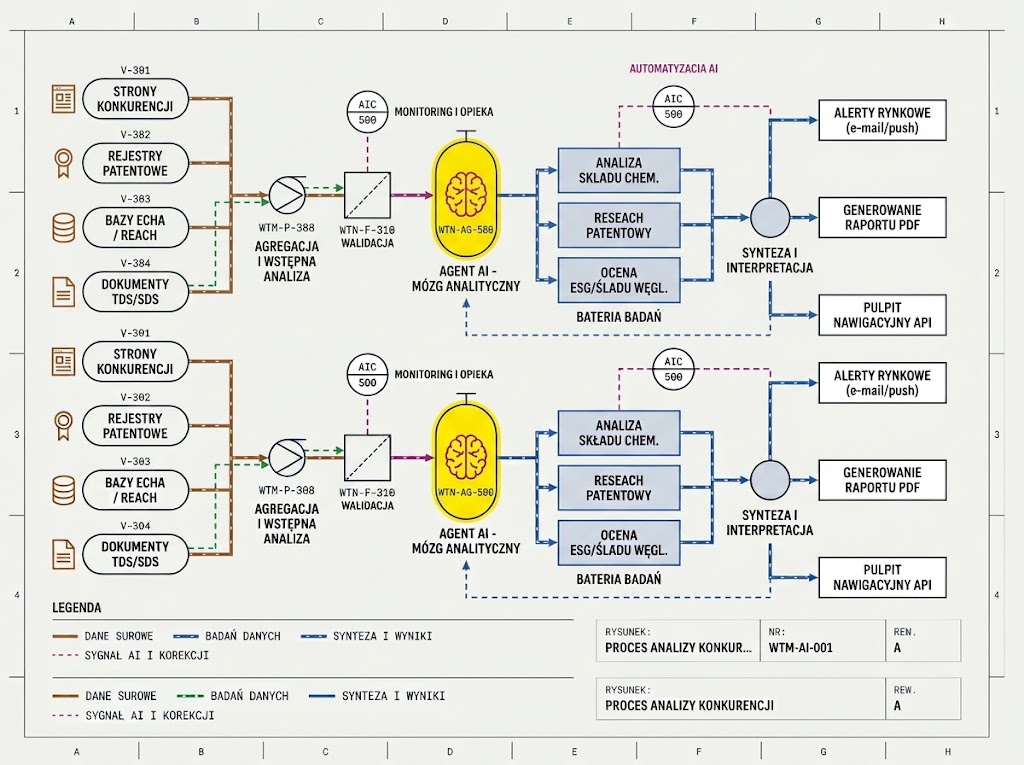
Analizy konkurencji w branży chemii przemysłowej
Autonomiczny agent AI, który w sposób ciągły zbiera, syntetyzuje i interpretuje dane rynkowe z setek źródeł w czasie rzeczywistym
Branża
Zakres
AI + SQL ETL
Powiedz, gdzie utykają Twoje dane
Opisz proces, który trwa za długo, albo raport, któremu nikt nie ufa. Odpiszemy, jak byśmy do tego podeszli i czy audyt ma sens.